

强化学习如何把握金融决策的最佳时机?孙羽助理教授合作论文在Management Science发表
2026-11-19 14:38:13
近日,北京大学汇丰商学院助理教授孙羽合作论文《扩散过程最优停止策略的学习及其金融应用》(“Learning to Optimally Stop Diffusion Processes, with Financial Applications”)在《管理科学》(Management Science)(Volume 72, Issue 9, September 2026, 7399–7417)发表。论文合作者为香港理工大学应用数学系及会计与金融学院教授戴民、香港理工大学应用数学系教授许左权,以及哥伦比亚大学工业工程与运筹学系教授周迅宇。
《管理科学》(Management Science)由美国运筹学与管理科学研究协会(INFORMS)出版,是美国德克萨斯大学(达拉斯)遴选的24本商学院顶级学术期刊(简称UTD 24)、英国《金融时报》评定的50本商学院顶级期刊(简称FT 50)和北京大学汇丰商学院发布的“中国经管学科国际科研发表数据检索系统”(简称PHBS 50)的50本核心期刊之一。期刊内容涵盖金融、运营管理、信息系统、行为决策等领域,注重运用严谨的理论、实验和实证方法研究重要管理问题,并鼓励跨学科研究。
对美式期权持有者而言,是立即行权、兑现收益,还是继续等待更好的机会?这类在不确定环境中选择最佳行动时点的问题,被称为“最优停止问题”。传统求解方法通常需要事先掌握描述市场变化的数学模型,但现实中的模型参数往往难以准确估计,甚至无法获得;当问题涉及多个资产或大量状态变量时,传统数值方法还会面临计算复杂度急剧上升的“维数灾难”。本文探讨的是,能否不依赖对完整模型的预先估计,而是通过强化学习,从数据与环境反馈中学会何时行动。
作者提出一套求解有限期限最优停止问题的连续时间强化学习框架。其核心思路是通过“惩罚近似”,将最优停止问题转化为仅包含两种行动的随机最优控制问题,从而与已有的连续时间强化学习理论相衔接。在学习阶段,算法利用伯努利分布对行动进行随机化,并引入熵正则化,在“停止”与“继续”之间开展探索,兼顾学习环境信息与优化决策收益。作者进一步结合鞅方法设计了离线与在线两类算法,并证明了策略迭代的快速收敛能力。
研究通过多组模拟实验检验了这一方法的有效性,包括高维状态下的美式期权行权和考虑比例交易成本的投资组合选择问题。本研究将最优停止、随机控制与强化学习相结合,为模型信息不完备环境中的金融时机决策提供了新的理论与算法工具。
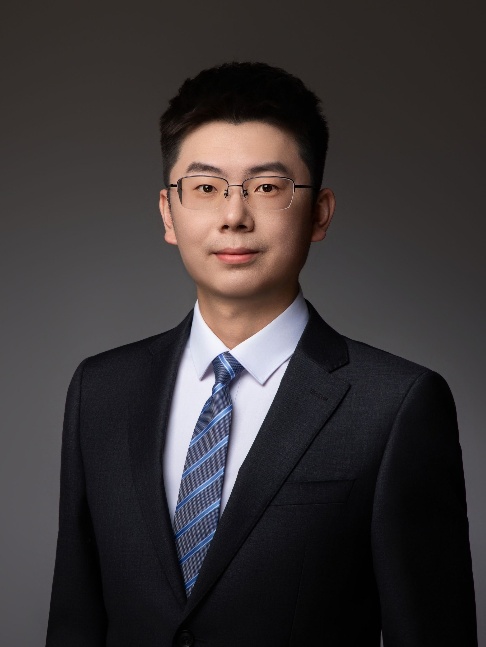
孙羽,北京大学汇丰商学院助理教授,香港中文大学系统工程与工程管理学博士(金融工程方向),主要研究领域包括行为金融与经济学、投资组合选择与资产定价、强化学习与随机控制等,曾在《管理科学》(Management Science)等期刊发表论文。